

Observe o efeito do bot no serviço
Um bot pode executar uma finalidade legítima e ainda produzir uma carga prejudicial quando falta coordenação. Consultas simultâneas, repetições automáticas e agendamentos concentrados podem ocupar recursos de um serviço e afetar outros usuários. A intenção da equipe não elimina esse efeito operacional.
Para avaliar o comportamento, observe o trabalho total enviado, o custo das operações e a capacidade acordada com o responsável pelo destino. O objetivo é uma automação previsível, autorizada e capaz de reduzir o ritmo quando necessário. Imitar pequenos gestos humanos na interface não substitui esse controle de engenharia.
A expressão DDoS descreve uma negação de serviço distribuída; uma análise de impacto não deve rotular automaticamente todo aumento de tráfego como ataque. Ainda assim, vários executores legítimos podem gerar padrões de carga semelhantes aos de uma sobrecarga distribuída se todos insistirem ao mesmo tempo.
O sinal relevante é a relação entre demanda e recursos disponíveis, acompanhada das regras de acesso. Uma operação madura consegue explicar por que cada requisição existe, quais limites a governam e como o conjunto será interrompido. Essa capacidade de controle é mais útil do que tentar inferir segurança apenas pela aparência do bot.
198.51.100.10:8080203.0.113.24198.51.100.20:80802001:db8::24Some os trabalhadores, mesmo com IPs diferentes
Não existe uma quantidade universal de requisições por segundo por IPv4 ou IPv6 que seja segura para qualquer site. Um endpoint pode executar uma leitura simples, enquanto outro produz um relatório caro. Limites também podem considerar conta, credencial, organização ou operação, além da origem de rede.
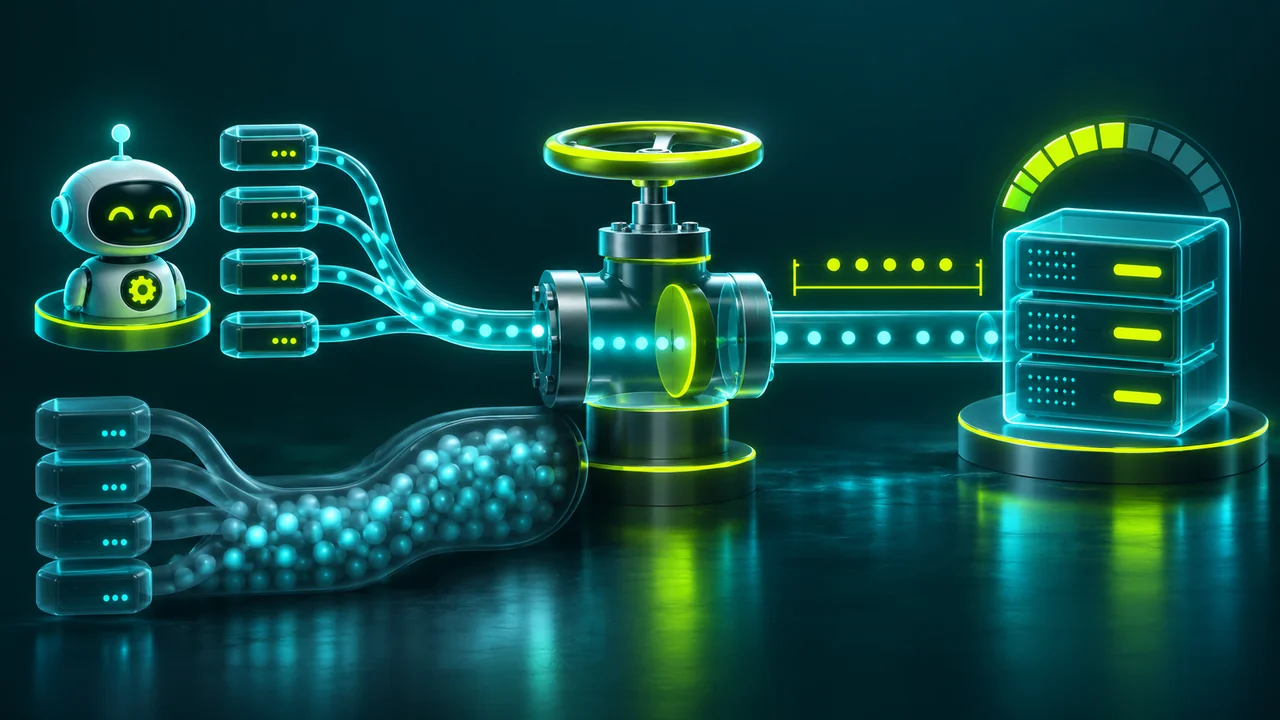
Dividir uma mesma carga entre mais endereços não cria capacidade adicional no destino. Defina um orçamento global para o serviço acessado e distribua esse orçamento entre os trabalhadores. O limite precisa continuar válido quando novos executores forem adicionados ou quando um processo utilizar uma modalidade de proxy diferente.
Como exemplo de contagem, quatro trabalhadores que enviam meio pedido por segundo cada produzem dois pedidos por segundo no total. Usar um ou quatro endereços não altera essa soma. Esse exemplo é apenas aritmético, não uma recomendação de taxa segura.
O mesmo raciocínio vale para vários projetos de uma empresa que consultam o mesmo destino sem saber uns dos outros. Um coordenador compartilhado ou uma política central de agendamento ajuda a manter a visão do conjunto. Registre também chamadas auxiliares do navegador, porque uma única tarefa de negócio pode gerar várias requisições de rede.
Taxa, concorrência e custo precisam ser vistos juntos
A taxa informa quantas operações começam em um período; a concorrência informa quantas permanecem em andamento. Quando o destino fica lento, tarefas abertas podem se acumular mesmo sem aumento da taxa de entrada. Isso ocupa conexões, memória e outros recursos dos dois lados.
Controle tanto o início de trabalho quanto o número de operações simultâneas. Observe a distribuição de duração, e não apenas a média, porque poucas tarefas muito lentas podem reter recursos por bastante tempo. O limite deve refletir o comportamento real das operações e ser revisado quando a aplicação consultada muda.
Classifique operações com custos diferentes quando houver evidência suficiente. Uma busca curta, um download volumoso e a geração de um documento podem exigir orçamentos separados. Também considere horários de manutenção e períodos de alta utilização informados pelo responsável pelo sistema.
O planejamento deve proteger a continuidade do destino e do seu próprio processo. Se a fila crescer, priorize o trabalho necessário e adie o que pode esperar. Aumentar executores para esvaziar uma fila sem identificar o gargalo pode transferir o acúmulo para o serviço remoto e tornar a recuperação ainda mais difícil.
198.51.100.10:8080203.0.113.24198.51.100.20:80802001:db8::24Impeça que as tentativas ampliem uma falha
Uma resposta que demora mais do que o esperado pode levar o cliente a desistir e tentar novamente enquanto a operação anterior ainda está sendo processada. Se várias camadas repetem a mesma chamada, o volume real pode crescer muito além da quantidade de tarefas originais.
Defina quem é responsável por tentar novamente e imponha um limite de tentativas e um prazo total. Use espera progressiva e dispersão temporal para evitar que todos retornem juntos. Esses mecanismos servem para reduzir sobrecarga durante falhas, mantendo o orçamento global em vigor durante todo o processo de recuperação.
O código HTTP 429 indica excesso de requisições e pode incluir uma orientação de espera por Retry-After. Interprete essa sinalização conforme o contrato de integração e reduza ou pause o trabalho aplicável. Uma resposta rápida de erro não deve provocar aceleração do robô.
Da mesma forma, uma falha de autenticação não é resolvida repetindo chamadas com mais intensidade. Categorize erros para decidir entre espera, correção de configuração e intervenção humana. Quando a mesma condição afeta muitas tarefas, interrompa a admissão de novas operações até existir evidência de que o serviço pode ser utilizado novamente.
Para ações que alteram dados, investigue o resultado antes de repetir após uma resposta perdida. Uma operação pode ter sido concluída mesmo quando o cliente não recebeu confirmação. Utilize identificação de negócio e mecanismos de idempotência disponíveis para evitar duplicações.
Essa disciplina protege o destino de trabalho desnecessário e protege sua empresa de resultados inconsistentes. A recuperação deve ser observável: registre quantas tarefas foram retomadas, quantas já estavam concluídas e quantas exigiram análise. Sem essa distinção, uma queda curta pode gerar horas de consultas e alterações repetidas que parecem trabalho novo nos painéis.
Reduza chamadas que não agregam informação
Revise a frequência de atualização conforme a necessidade do negócio. Consultar o mesmo dado muitas vezes não produz valor quando ele muda raramente ou quando a decisão só será tomada mais tarde. Utilize cache e reaproveitamento quando permitidos, respeitando validade e sensibilidade dos dados.
Prefira interfaces de atualização incremental ou notificações quando o sistema oferecer essas opções. Elimine consultas duplicadas entre trabalhadores e agrupe pedidos apenas quando a API permitir. Uma melhoria no planejamento pode reduzir carga e custo sem diminuir a qualidade entregue, porque evita trabalho cujo resultado já estava disponível.
Meça, combine limites e teste com autorização
Acompanhe requisições totais por destino, concorrência, latência, códigos de resposta, tentativas e operações úteis concluídas. Acrescente tamanho de fila e idade da tarefa mais antiga para perceber quando o atraso está crescendo. Relacione esses indicadores a mudanças de versão e agendamento.
Um aumento de erros após uma implantação pode revelar uma consulta auxiliar repetida ou um comportamento de retry alterado. Defina condições de parada e responsáveis por atendimento antes do incidente. O painel deve permitir reduzir o fluxo de maneira coordenada, sem depender de localizar manualmente todos os executores em diferentes ambientes.
Testes de capacidade devem ocorrer em ambiente próprio ou com autorização explícita do responsável pelo destino, com escopo, janela e condição de interrupção definidos. Não descubra o limite de um serviço de terceiros aumentando a carga até causar falha. Compartilhe evidências com o parceiro para ajustar o volume permitido e revise o acordo quando o processo crescer.
Na VLSM.io, IPv4, IPv6 e proxies podem compor a conectividade do projeto; a utilização responsável depende também do coordenador de tarefas e das regras da aplicação. A melhor escala é aquela que entrega resultados sustentáveis sem comprometer o serviço consultado. Documente os limites aprovados e mantenha um contato operacional para revisar o planejamento quando a demanda mudar.
Referências institucionais
Documentos de referência sobre os temas abordados neste artigo.